자료구조란?
Data Structures는 데이터를 구성, 저장, 조작하는 방법을 의미한다.
많은 자료구조가 있지만 이번 포스팅에서는 Array, List, Stack, Queue, Tree, Graph에 대해 쓰겠다.
이런 자료구조는 데이터를 효과적으로 표현하기 위해 만들어진 새로운 구조들이다.
Abstract Data Type (추상 자료형)
Abstract Data Type (이하 ADT)은 프로그래밍을 함에 있어 데이터를 추상화하여 논리적인 구조를 정의한 것을 의미한다.
기존에 없는 나에게 필요한 데이터 타입을 만드는 것이라고 볼 수 있다. 이러한 개념을 구체적으로 구현하는 것은
구현 세부 사항을 나타내는데, ADT는 그 구현을 추상화하고, 사용자가 데이터를 쉽게 다룰 수 있도록 한다.
(ADT를 잘 만든다는 건 개발 디자인을 잘한다고 볼 수 있다고 생각한다.)
ADT의 장점
- 데이터에 대한 정보를 이해하고 저장하는 방식을 결정함으로써 최적의 알고리즘을 개발할 수 있다.
- 프로그래밍을 효율적으로 구현할 수 있도록 도와준다.
- 동일한 속성을 만족하면 재사용성이 뛰어나고 모듈화가 되어 있어 편리하다.
Array and List
Array (배열)
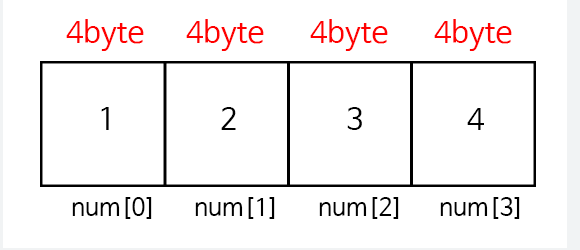
- 배열은 연속된 메모리 공간에 같은 타입의 데이터를 순차적으로 저장하는 자료구조
- 인덱스를 통해 빠르게 접근할 수 있다.
- 크기가 고정되어 있기 때문에 배열을 생성할 때 크기를 지정해줘야 한다. (귀찮다는 단점이지만 강력한 장점이라고 생각된다.)
- 배열이 가득 차는 경우 새로운 데이터를 추가할 수 없거나 기존 데이터를 삭제해야 할 수 있다. (리스트는 가변적이라 변경에 편리하다.)
고정되어 있다는 불편함에도 변경이 편리한 리스트가 아닌 배열을 사용하는 2가지 장점
- 배열 내의 원소가 모두 같은 타입인걸 알기에 불필요한 연산이 사라진다.
- 크기가 고정되어 있기 때문에 pair wise or element-wise가 쉽다.
List (리스트)
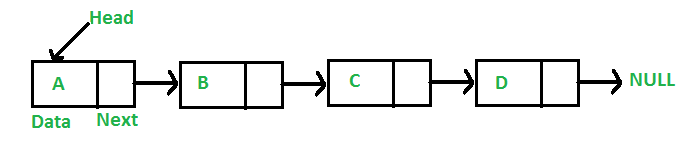
- 리스트는 가변 길이의 배열과 같은 자료구조로 인덱스를 통해서 요소에 접근할 수 있다.
- 파이썬에서 list 자료구조는 다양한 데이터 타입을 포함할 수 있다.
- 가변적인 길이를 가지고 있기 때문에, 새로운 데이터 추가에 대한 제한이 거의 없다는 장점이 있다.
Stack and Queue
stack (스택)
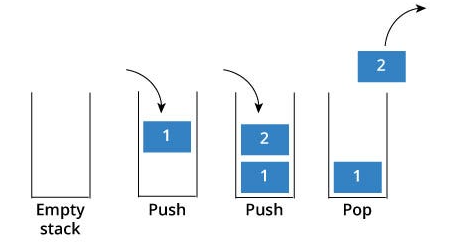
- Stack은 LIFO(Last In First Out)(나중에 들어간 원소가 먼저 나오는) 구조를 가진 자료구조
- 구조는 List와 비슷하나 기능적인 면에서 차이가 있다.
- Stack은 삽입과 삭제가 항상 제일 뒤(최근)에서 이루어진다. 그리고 가장 최근에 삽입한 요소를 top이라고 지칭한다.
- Stack 구조는 컴퓨터 가상메모리의 Stack 영역에서 사용되는데, 함수가 호출되면서 다시 복귀할 주소를 저장하거나, 지역변수, 매개변수 등을 임시로 저장하는 데에 쓰인다.
Queue (큐)
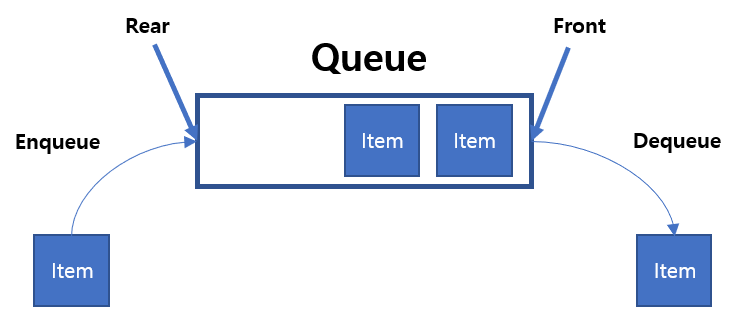
- Queue는 FIFO(First In First Out)(먼저 들어간 원소가 먼저 나오는) 구조를 가진 자료구조
- 놀이공원이나 은행의 대기줄처럼 먼저 들어온 요소를 먼저 내보낸다.
- Queue에서는 front와 rear로 가장 먼저 들어온 요소(front)와 제일 마지막에 들어온 요소(rear)에 접근한다.
- Deque: Double-ended queue의 약자로 데이터를 양방향에서 추가하고 제거할 수 있는 자료구조이다.
- 파이썬에서는 collections의 deque와, queue를 import 해서 deque와 queue 자료구조를 사용할 수 있다
Tree (트리)
Tree는 데이터 속 항목을 계층적으로 구조화하는 자료구조
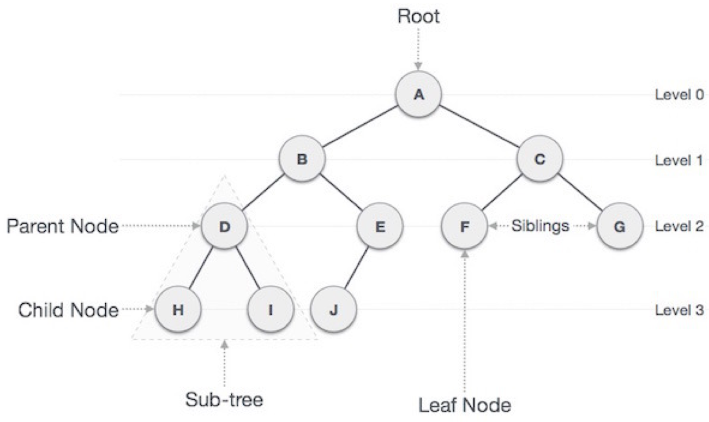
- Tree 용어 설명
- Node : 트리 구조의 교점으로 Node는 데이터(Value)를 가지고 있고, 자식노드를 가지고 있다.
- Root Node: 트리구조에서 가장 위에 있는 노드. 즉 시작점이 되는 노드이다.
- Edge: 트리를 구성하기 위해 노드와 노드를 연결하는 선이다.
- level: 트리의 특정 깊이를 가지는 노드의 집합입니다.
- degree: 각 노드가 지닌 가지의 수를 말하며 '차수'라고도 합니다. (보통 tree에서의 degree는 child node의 개수이다.)
- Leaf Node(Terminal Node): 하위에 다른 노드가 연결되어 있지 않은 노드
- Internal Node : Leaf노드를 제외한 중간에 위치한 노드들을 말합니다.
Tree의 유형
- Binary Tree (이진 트리)
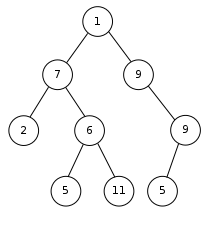
- 자식 Node가 최대 둘 뿐인 Tree.
- 비슷한 Tree로는 자식 node가 최대 세 개인 Ternary Tree가 있다.
- Binary search Tree (이진 탐색 트리)
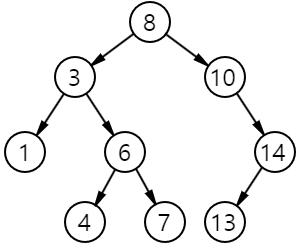
- 구조는 Binary Tree와 같이 자식 Node가 최대 2개인 Tree이나 Node 간의 대소 비교를 통해 Node를 위치시킨다는 특징이 있다.
- 주로 부모노드를 기준으로 데이터가 작다면 left child로, 크다면 right child로 배치한다.
- Balanced Tree (밸런스 트리)
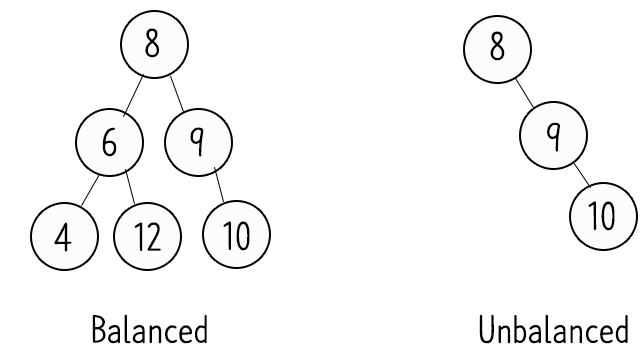
- 위의 Binary Tree나 Binary Search Tree의 경우 한쪽으로 편향된 구조를 가질 수 있다는 단점이 있다.
- 이런 구조는 배열과 같은 선형구조이기 때문에 Leaf Node 탐색 시 효율이 떨어짐.
- 이를 보완하기 위해서 Balanced Tree 구조를 사용한다.
- Balanced Tree는 어느 한쪽으로 데이터가 치우치지 않도록 균형을 지킬 수 있는 규칙을 가지고 있다는 특징이 있다.
- e.g. B-tree, B+tree
이외에도 완전 이진 트리, Full Binary Tree, Perfect binary Tree 등이 있다.
Graph (그래프)
Graph는 데이터 간의 관계를 표현하기 위한 자료구조
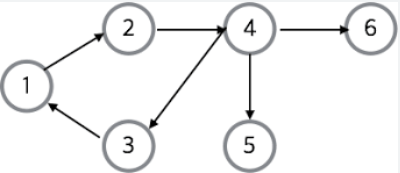
- Graph 용어 설명
- Vertex: Tree에서의 Node와 같은 개념
- Edge: 정점과 정점을 있는 선
- Weight: 간선의 크기가 있는 경우 그 가중치값
- Degree: 정점에 연결되어 있는 간선의 수
- Out-degree: 방향이 있는 그래프에서 정점에서부터 출발하는 간선의 수
- In-degree: 방향이 있는 그래프에서 정점으로 들어오는 간선의 수
- Path: 정점 V_i에서 V_j까지 간선으로 연결된 정점을 순서대로 나열한 리스트 (e.g. 1 → 6 = {1, 2, 4 6})
- Path Length: 경로를 구성하는 간선의 수
- Cycle: 경로 중에서 경로의 시작 정점과 마지막 정점이 같은 경로 {e.g. 4 → 4 = {4, 3, 1, 2, 4})
Graph의 유형
- undirected graph (무방향 그래프)
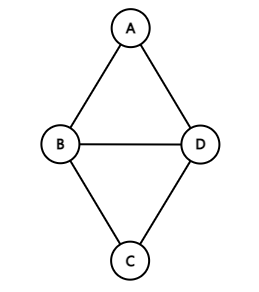
- 두 정점을 연결하는 간선에 방향이 없는 그래프. 가장 기본적인 그래프
- 간선을 (A, B)와 같은 형태로 표현하고 (A, B)와 (B, A)는 같은 간선이다.
- directed graph (방향 그래프)
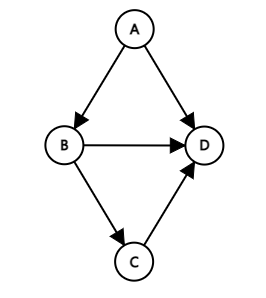
- 간선에 방향이 있어 정해진 방향으로만 이동할 수 있는 그래프
- 이 경우 간선을 <A, B>로 표현하는데, A는 출발 정점, B는 도착 정점이다.
- weighted graph (가중치 그래프)
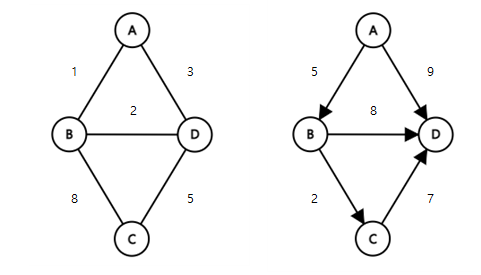
- 정점을 연결하는 간선에 가중치(weight)를 할당한 그래프
Time and Space complexity
Space complexity (공간 복잡도)
프로그램이 실행되고 완료되는 데 필요한 메모리
- 고정 공간 요구량(Fixed space requirements): 자료구조가 사용하는 고정된 메모리 공간을 의미. 고정된 크기를 갖는 변수(int, double)가 여기에 포함되며 크기가 정해진 배열의 경우에도 고정 공간 요구량에 속한다.
- 가변 공간 요구량(Variable space requirements): 필요에 따라 동적으로 할당, 해제되는 메모리 공간을 의미. 특정 instance에 따라서 size가 달라지는 변수들이 여기에 속한다
Time complexity (시간 복잡도)
프로그램이 실행되고, 완료되는 데 걸리는 시간
- Time complexity는 Compile Time과 Execution(Running) Time으로 나뉜다.
- Execution Time에서 for문과 같이 반복이 일어나는 부분에서 Time Complexity가 증가하게 된다.
Time complexity Algorithm
Big Oh, Big Ω(오메가), and Big Θ(쎄타) notation
- 복잡도를 표현하는 방법으로는 Big Oh, Big Ω, and Big Θ notation을 사용한다.
- Big Oh는 최악의 경우(최대로 걸릴 수 있는 상한 시간), Big Ω는 최선의 경우(최소로 걸릴 수 있는 하한 시간), Big Θ는 평균의 경우로 나타낸다.
- 보편적으로 Big Oh 표기법을 가장 많이 씀.
- Big Oh: 주어진 복잡도 f(n)에 대해서 어떤 상수 c와 g(n)을 곱한 값이 f(n) 보다 크다면 f(n)의 시간 복잡도는 O(g(n))으로 표현할 수 있다.
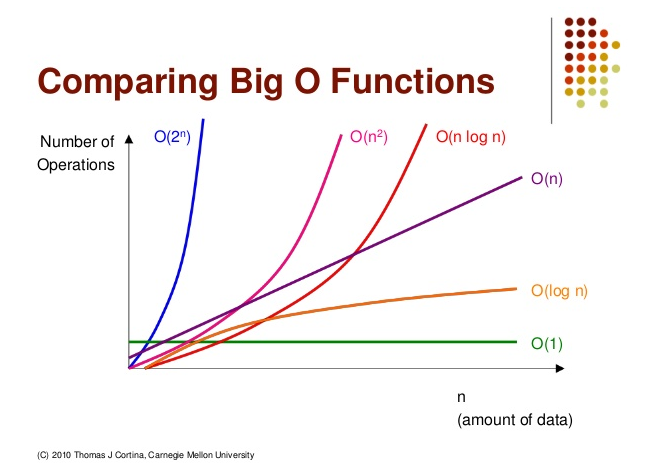
O(N^3) - cubic 이상의 알고리즘은 잘 쓰지 않는다. O(2^N) - exponential, O(N!) - factorial
이어드림 스쿨의 김용담 강사님의 컴퓨터 공학 개론 자료를 출처로 하고 있습니다.
'Computer' 카테고리의 다른 글
| Operating System (0) | 2023.04.03 |
|---|---|
| Computer Architecture (0) | 2023.03.31 |
| Algorithm (0) | 2023.03.30 |
| Computer Science and Engineering (0) | 2023.03.28 |
| 인공지능에 관하여 (0) | 2023.03.27 |


